태그 :: Qwen-3.6-27b
전체 2개
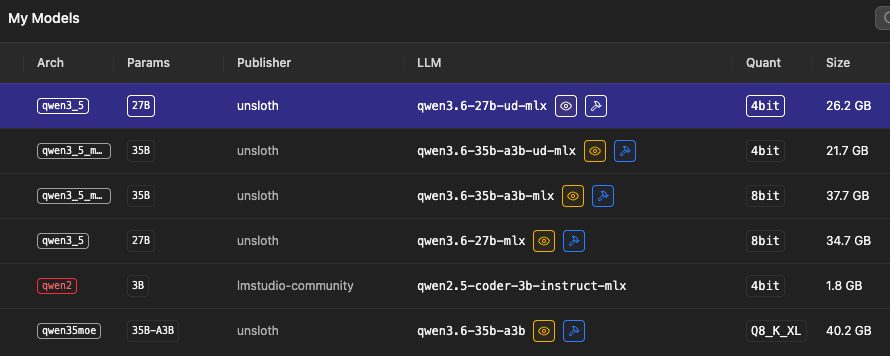
Qwen 3.6 / 35b a3b / 27b / 4bit, 8bit, mlx / etc
다양한 모델을 테스트하며 2주간 1억 토큰 이상의 개발 작업을 진행해 본 결과, 당분간은 Qwen 3.6 35b a3b 모델을 LM Studio와 Claude Code 환경에서 주력으로 사용할 계획입니다. Deepseek-V4 Flash가 기대되긴 하지만, 어째서인지 아직 LM …
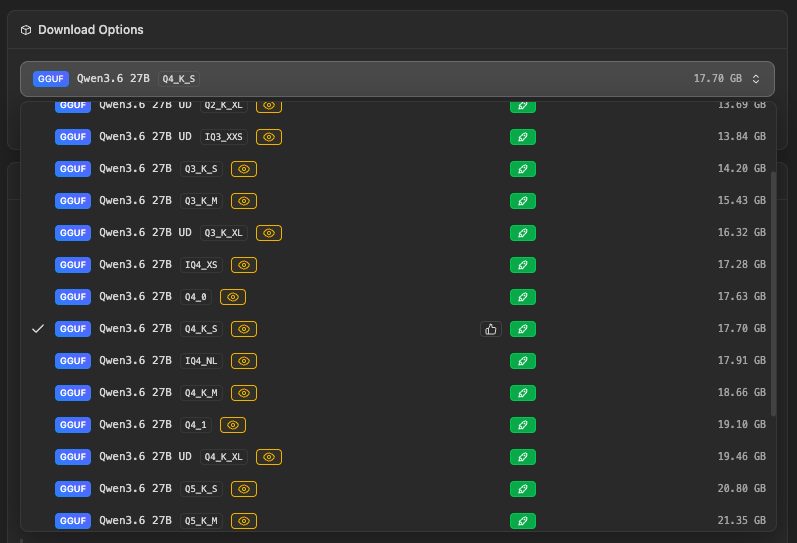
Unsloth/Qwen-3.6-27b
qwen-3.6-27b 모델을 Unsloth 에서 파인튜닝한 모델을 받아서 돌려 봤습니다. 양자화는 Q8_K_XL 입니다. 앞서 글 올린 Qwen-3.6-36b-a3b 는 MoE 모델이라 대충 70~80Tps 정도의 속도가 나왔는데, 역시나 Dense모델인 27b는 속도가 생각보다 많 …